




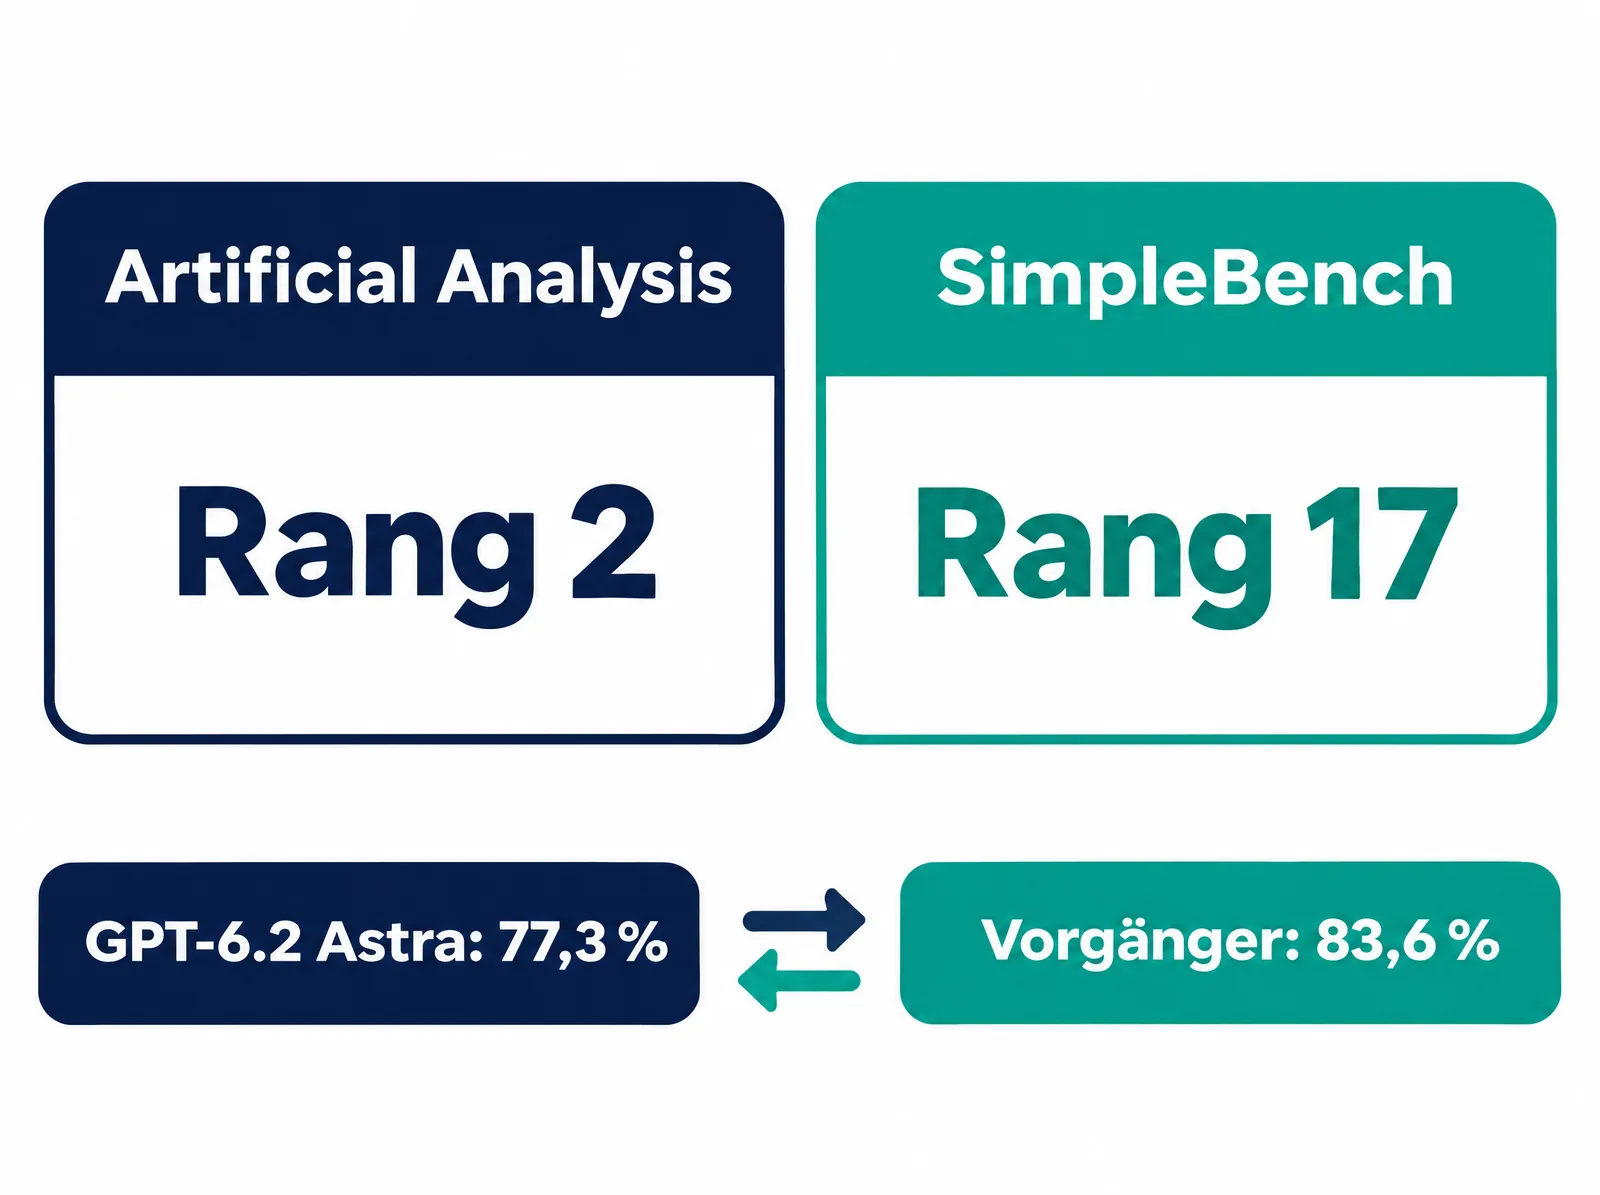
Am 21. November 2026 um 14:16 Uhr MEZ startete auf Hacker News, einem Forum für Technikthemen, eine Diskussion mit dem Titel „Astra 6.2 and Sol 6.2 flop at Simple Bench“; bis zum Abend kamen 143 Punkte und mehr als 130 Kommentare zusammen[1]. Der Anlass: Im unabhängigen Benchmark SimpleBench erreichen die neuen OpenAI-Modelle GPT-6.2 Astra 77,3 Prozent (Rang 17) und GPT-6.2 Sol 69,9 Prozent (Rang 30) – deutlich weniger als ihre Vorgänger[2]. Das Release selbst, seine Preise und die erste Kritik haben wir bereits eingeordnet. Hier geht es um die Frage dahinter, die auch die Fachdiskussion dominiert: Wie bewertet man neue Modelle unabhängig von den Zahlen der Hersteller – und wie finden Sie heraus, was für Ihre Aufgaben wirklich funktioniert?
SimpleBench wird vom Team hinter dem YouTube-Kanal „AI Explained“ betrieben und stellt Modellen über 200 Multiple-Choice-Fragen zu Alltagslogik: räumlich-zeitliches Denken, soziale Situationen und Trickfragen, die sprachliche Robustheit prüfen[2]. Der Benchmark-Katalog von Epoch AI, einem Forschungsinstitut für KI-Daten, beziffert den Testsatz auf 213 Fragen mit je sechs Antwortoptionen[3]. Jedes Modell durchläuft den Test fünfmal, gewertet wird der Durchschnitt (AVG@5)[2][3].
Alle folgenden Zahlen sind Angaben des Benchmark-Betreibers, Stand 21. November 2026[2]:
OpenAI belegt die Stärken von GPT-6.2 in der eigenen Ankündigung mit einer selbst gewählten Benchmark-Auswahl, etwa für Code-Änderungen an echten Codebasen und Wissensarbeit – Herstellerangaben, wie bei jedem Anbieter[4]. Spannend wird es im Vergleich: Der unabhängige Vergleichsdienst Artificial Analysis, der Modelle selbst nachmisst, führt GPT-6.2 in seinem Intelligence Index – einem Sammelwert aus neun Einzeltests – als Nummer 2[5]. SimpleBench sieht dieselben Modelle auf Rang 17 und 30[2]. Beide können recht haben: Sie messen schlicht Verschiedenes.
Dass einzelne Ranglisten wackeliger sind, als sie wirken, zeigt auch die Forschung: Eine ACL-Studie von 2024 fand, dass schon kleinste Änderungen an Multiple-Choice-Tests – etwa die Reihenfolge der Antwortoptionen – Modelle um bis zu acht Ranglistenplätze verschieben[6]. Dazu kommt das Kontaminationsproblem: Geraten Benchmark-Fragen in die Trainingsdaten, schneiden Modelle besser ab, als sie sind[7]. Im Hacker-News-Thread verteidigen Kommentatoren SimpleBench gerade deshalb, weil die Fragen überwiegend nicht öffentlich sind; Kritiker halten die Trickfragen dagegen für wenig aussagekräftig für echte Arbeit[1]. Auch die Praxisberichte zu GPT-6.2 widersprechen sich dort – von „bricht lange Aufgaben vorzeitig ab“ bis „schneller und besser als der Vorgänger“[1].
Genau da setzen Sie an. Statt Leaderboards zu glauben, bauen Sie sich einen kleinen Privat-Benchmark aus echten Aufgaben – einmal angelegt, lässt er sich bei jedem neuen Modell in einer Stunde wiederholen. Unsere Empfehlung aus der Projektpraxis:
Ein schwacher Wert in einem einzelnen Benchmark ist ein Prüfauftrag, kein Wechselgrund. Erst wenn mehrere unabhängige Quellen und Ihre eigenen Testfälle in dieselbe Richtung zeigen, lohnt die Rechnung aus Leistung, Preis und Umstellungsaufwand – eine Übersicht über die großen Modellfamilien und ihre Kosten finden Sie in unserem Modellvergleich für Unternehmen.
| Signal | Beim Modell bleiben | Wechsel ernsthaft prüfen |
|---|---|---|
| Eigene Testfälle | ✓ Ergebnisse stabil gut, keine K.O.-Fehler | ✗ Wiederholt erfundene Fakten oder ignorierte Vorgaben |
| Unabhängige Benchmarks | ✓ Ein einzelner Ausreißer nach unten | ✗ Mehrere Quellen zeigen dasselbe Muster |
| Kosten je Aufgabe | ✓ Im Rahmen, Umstieg brächte wenig | ✗ Alternative liefert Gleichwertiges deutlich günstiger |
| Umstellungsaufwand | ✓ Tiefe Integration, viele angepasste Prompts | ✗ Modell per Schnittstelle in Minuten austauschbar |
Der aktuelle Fall ist dafür ein Lehrstück: Wer nur die OpenAI-Ankündigung liest, sieht ein Spitzenmodell[4]; wer nur SimpleBench liest, einen Absteiger[2]. Die Wahrheit für Ihr Unternehmen steht in keiner der beiden Tabellen – sie steht in Ihren eigenen Testfällen.
SimpleBench ist ein unabhängiger Multiple-Choice-Benchmark des Teams hinter dem YouTube-Kanal „AI Explained“ mit über 200 Fragen zu Alltagslogik: räumlich-zeitliches Denken, soziale Situationen und sprachliche Trickfragen; gewertet wird der Durchschnitt aus fünf Durchläufen[2][3]. Laut Epoch AI umfasst der Testsatz 213 Fragen mit je sechs Antwortoptionen[3].
Mit einem kleinen Privat-Benchmark: 20 bis 30 echte Fälle aus dem Arbeitsalltag, vorab festgelegte Bewertungs- und K.O.-Kriterien, mehrere Durchläufe pro Fall sowie Notizen zu Preis und Antwortzeit. Getestet wird mit anonymisierten oder erfundenen Daten, nicht mit echten Kundendaten.
Nein, nicht allein deshalb. Ein einzelner Benchmark-Wert ist ein Anlass, die eigenen Testfälle laufen zu lassen. Erst wenn eigene Tests, mehrere unabhängige Quellen und die Kostenrechnung übereinstimmen, lohnt ein schrittweiser Wechsel – zumal GPT-6.2 je nach Benchmark auf Rang 2[5] oder Rang 17 steht[2].
- Hacker News: Astra 6.2 and Sol 6.2 flop at Simple Bench (21.11.2026): news.ycombinator.com
- SimpleBench: Leaderboard und Methodik (abgerufen 21.11.2026): simple-bench.com
- Epoch AI: SimpleBench, Benchmark-Katalog (abgerufen 21.11.2026): epoch.ai
- OpenAI: Introducing GPT-6.2 Astra and Sol (abgerufen 21.11.2026): openai.com
- Artificial Analysis: Independent analysis of AI models (abgerufen 21.11.2026): artificialanalysis.ai
- ACL 2024: When Benchmarks are Targets: Revealing the Sensitivity of Large Language Model Leaderboards (01.08.2024): aclanthology.org
- arXiv: Benchmark Data Contamination of Large Language Models: A Survey (06.06.2024): arxiv.org